El campo “ingresos” llega en euros en una filial y en céntimos en otra. Un CRM admite fechas imposibles; un conector duplica pedidos al reanudarse; la definición de cliente activo cambia sin actualizar el cuadro de mando. El error se propaga a modelos y automatizaciones que deciden a escala.
El 4 de noviembre de 2026, AWS describió un agente de calidad de datos en producción en Indegene: usa contexto para generar reglas, valida las propuestas y produce SQL o Python bajo gobierno humano. Ese mismo día, Google presentó su Agentic Data Cloud y destacó datos gobernados y contexto empresarial. Los agentes de calidad de datos pasan a integrarse en el flujo.
Por qué no bastan las reglas tradicionales
Nulos, tipos y duplicados son esenciales, pero no capturan significado. Un descuento del 80 % puede ser válido en liquidación e imposible en un contrato corporativo. Una dirección vacía es aceptable para un producto digital y bloqueante para un envío. La regla depende del dominio, fase, contrato y momento.
El agente convierte catálogo, esquema, tickets, políticas y correcciones en propuestas. Reduce trabajo repetitivo, pero toda regla que modifique o bloquee datos necesita propietario, pruebas y aprobación.
Funciones del agente
Descubrir y clasificar
Analiza esquema, perfil estadístico, linaje, frecuencia y uso. Los campos sensibles o vinculados a decisiones económicas reciben mayor criticidad.
Proponer reglas con contexto
Sugiere coherencia entre campos, límites por segmento, integridad referencial, secuencia temporal y conciliación entre sistemas. Explica fuente, intención y severidad.
Generar una implementación ejecutable
Traduce la regla aprobada a SQL, Python o un framework de calidad, con pruebas positivas y negativas. El código se revisa, aísla y versiona.
Supervisar e investigar
Ejecuta controles en el punto correcto, agrupa incidencias y relaciona cambios de origen. Recomienda causa y responsable sin borrar evidencias.
Aprender de decisiones gobernadas
Una decisión del data steward se convierte en contexto con alcance y caducidad. No cambia reglas por sí sola: cada versión repite aprobación y pruebas.
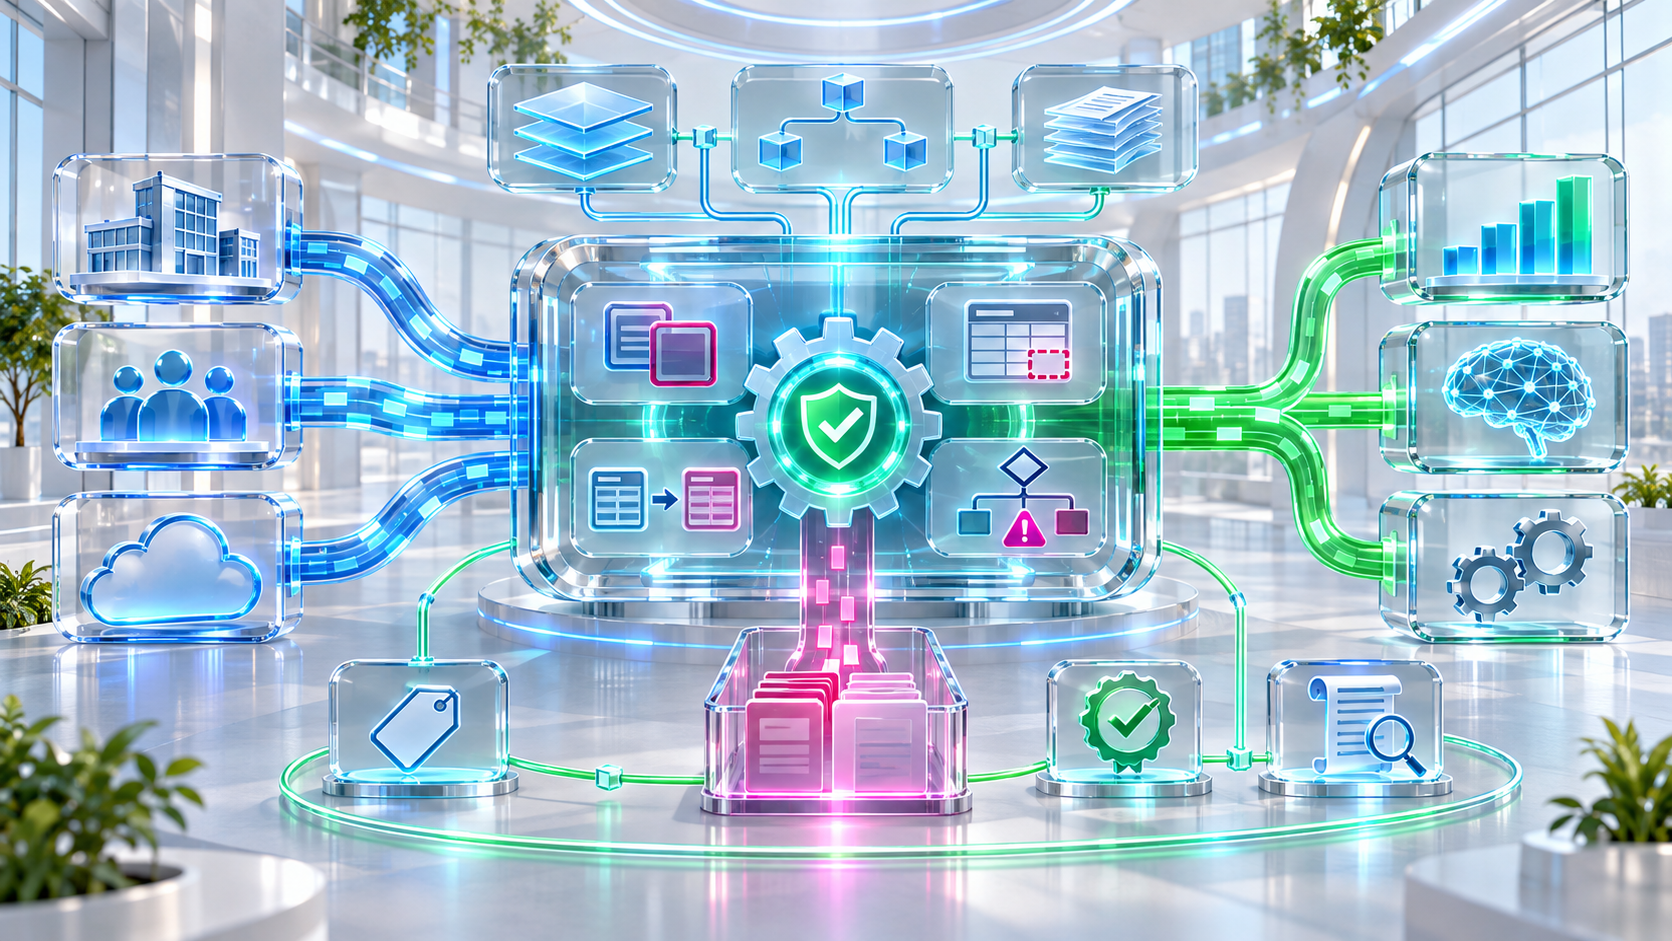
Arquitectura de referencia
- Fuentes: ERP, CRM, aplicaciones, archivos, eventos y SaaS.
- Catálogo y linaje: significado, propietario, sensibilidad, origen y consumidores.
- Conocimiento: políticas, glosario, reglas e incidentes.
- Agente: propone regla, severidad, prueba y posible corrección.
- Motor determinista: ejecuta la regla versionada.
- Flujo humano: aprueba, rechaza y gestiona excepciones.
- Observabilidad: mide cobertura, fallos, falsos positivos y resolución.
La IA interpreta y acelera; el motor repite el control; las personas asumen la política. Registra modelo, fuentes, versión de regla y muestra usada.
Ejemplo: pedidos entre e-commerce, ERP y logística
El agente descubre que el ERP registra unidades mientras un proveedor envía cajas. Propone que la cantidad convertida sea múltiplo del embalaje vigente en la fecha del pedido, consulta la tabla de producto y añade casos para cambios de formato, devoluciones y pedidos antiguos.
Tras la aprobación, la regla se ejecuta antes de reservar stock. Los registros dudosos quedan en cuarentena y el resto continúa. La alerta muestra origen, lote, producto, regla y consumidores. Se evita que el error termine en rotura de stock, cobros incorrectos y previsiones distorsionadas.
Calidad por criticidad
No todo fallo debe detener la pipeline. Define información, aviso, cuarentena y bloqueo. Pagos, cumplimiento o acciones automáticas exigen límites más estrictos que datos exploratorios.
Vincula cada regla a un SLO: validez, retraso, cobertura y tiempo de resolución. Una validación completa puede ejecutarse por lote; una regla crítica y barata, en cada evento.
Métricas de valor
- cobertura de campos y flujos críticos;
- incidentes detectados antes del consumidor;
- tiempo entre detección y resolución;
- falsos positivos y excepciones caducadas;
- reincidencia por fuente y cambio;
- reglas sin propietario, prueba o uso;
- impacto evitado en BI, IA y operaciones.
Riesgos y controles
- regla inventada: evidencia, explicación y aprobación;
- corrección destructiva: original, cuarentena y reversión;
- fuga de datos: enmascarado y acceso por columna;
- sesgo histórico: una excepción no es automáticamente una regla;
- proliferación: catálogo, propietario, versión y caducidad;
- ruido: deduplicación, severidad y enrutamiento;
- cambio silencioso: contratos de datos y schema drift.
Plan de implantación
- Selecciona un flujo con dolor y consumidor claros.
- Mapea datos críticos, propietarios e impacto.
- Establece el baseline de reglas e incidentes.
- Conecta catálogo, linaje y políticas.
- Genera pocas reglas y valídalas con especialistas e histórico.
- Ejecuta en modo sombra antes de bloquear.
- Añade cuarentena, workflow y métricas.
- Amplía por dominio sin perder la responsabilidad.
Datos fiables para decisiones automáticas
La IA acelera la creación de controles, pero la confianza procede del contexto, la ejecución repetible y la responsabilidad. No se trata de corregirlo todo automáticamente, sino de detectar pronto, explicar el impacto y llevar cada caso a quien corresponde.
ProativaIA crea plataformas de datos a medida, agentes y automatizaciones e integraciones entre ERP, CRM, BI y aplicaciones. Podemos implantar catálogo, controles, workflows y observabilidad según la criticidad del negocio.