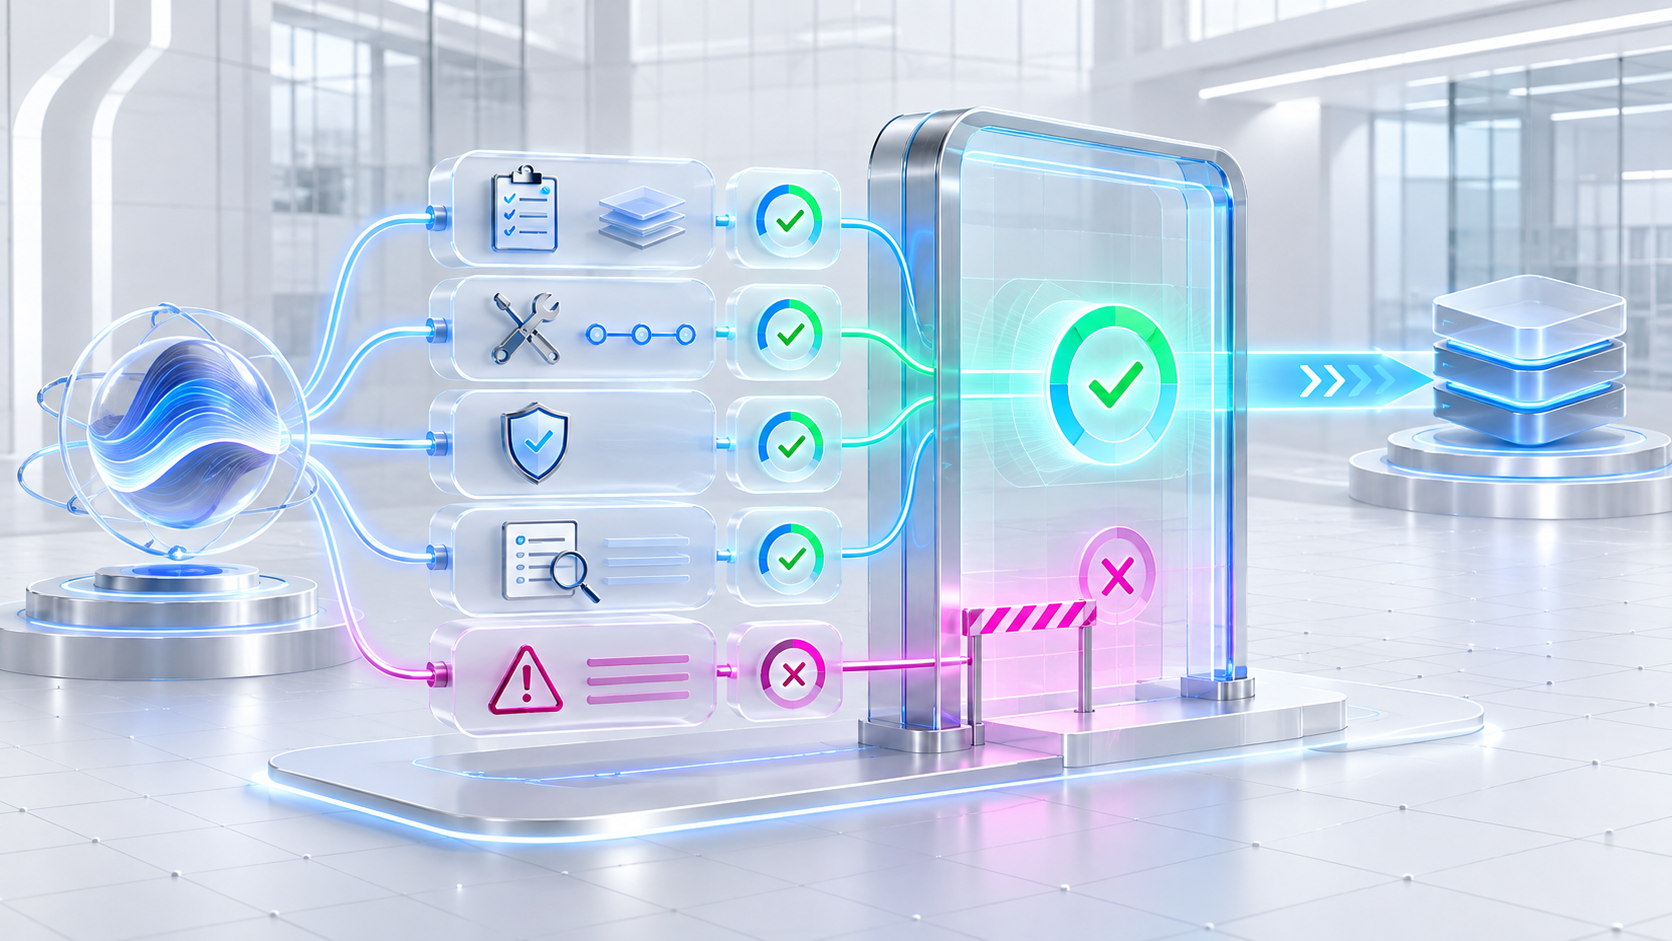
Un agente de atención resuelve bien 92 de 100 casos del conjunto de pruebas. Parece suficiente hasta descubrir que cuatro de los ocho fallos conceden descuentos fuera de política. La media oculta el riesgo. Para decidir si puede publicarse hay que evaluar la respuesta, el recorrido, las herramientas utilizadas, las negativas, el coste y el impacto de cada error.
El 4 de noviembre de 2026, AWS presentó modelos de decisión para verificaciones estrechas y repetibles en AgentCore Evaluations. Un día después, Microsoft insistió en operar los agentes como una disciplina continua, con suite de evaluación, presupuestos de coste y latencia y posibilidad de reversión. Las evaluaciones de agentes de IA se convierten así en ingeniería de producción.
Por qué las pruebas tradicionales no son suficientes
En software determinista, una entrada conocida produce una salida esperada. Un agente combina modelo, instrucciones, memoria, búsqueda, herramientas y datos variables. Dos ejecuciones pueden responder de forma distinta; una respuesta correcta puede haber usado una herramienta prohibida; un cambio de modelo puede mejorar el estilo y empeorar el cumplimiento.
Las pruebas convencionales siguen siendo necesarias para API, permisos y reglas. Las evals añaden una capa probabilística: ejecutan escenarios, registran la trayectoria y comprueban que el comportamiento siga dentro de límites aceptables.
Qué debe evaluarse
Finalización de la tarea
¿Se alcanzó el objetivo real? En cobros no basta con redactar un buen mensaje: hay que identificar el contrato, aplicar la política vigente y registrar la acción en el CRM.
Cumplimiento y seguridad
Comprueba alcance, privacidad, límites económicos, aprobaciones y negativas. Los criterios críticos deben medirse por separado de la puntuación media.
Fundamentación y precisión
Las afirmaciones deben estar respaldadas por fuentes recuperadas. La evaluación debe detectar citas ausentes, documentos obsoletos y conflictos con el sistema oficial.
Trayectoria de herramientas
Registra herramientas, orden, argumentos, repeticiones y resultado. Un agente puede llegar a la respuesta correcta después de consultar datos indebidos o repetir una operación con efecto económico.
Coste, latencia y resiliencia
Mide tokens, llamadas, duración, fallos y reanudaciones. Una mejora que multiplica por diez el coste también puede ser una regresión.
Construye un dataset representativo
Reúne escenarios con entrada, contexto, resultado esperado y criterios de aprobación. Combina casos frecuentes, excepciones, ambigüedades, entradas adversarias y fallos de integración. Los ejemplos reales deben anonimizarse y usarse con base jurídica adecuada conforme al RGPD.
Clasifica por riesgo. Un error de tono admite cierta tolerancia; una transferencia a la cuenta equivocada, ninguna. Añade segmento, idioma, canal y versión de política para localizar dónde cae la calidad.
Ejemplo: agente de reembolsos
El conjunto incluye solicitudes en plazo, fuera de plazo, compras duplicadas, ausencia de justificante, importes superiores a la autorización e intentos de saltarse las normas. La referencia no fija cada frase, sino decisión, evidencias, herramienta, aprobación y estado final.
Elige el evaluador adecuado
- código determinista: formato, campos, límites, llamadas e invariantes;
- regla de negocio: compara política y resultado;
- LLM como juez: utilidad, claridad y criterios semánticos;
- modelo de decisión: preguntas estrechas con opciones fijas y probabilidad calibrada;
- revisión humana: muestras críticas, nuevos riesgos y casos sin consenso.
Un juez de IA también se equivoca. Google advierte de sesgos de verbosidad, posición, complacencia y preferencia por respuestas de su propia familia. Valídalo frente a expertos, repite muestras para medir estabilidad y separa criterios en lugar de pedir una nota genérica.
Convierte métricas en controles de calidad
El control define condiciones objetivas para publicar: finalización superior al umbral, cero violaciones críticas, precisión de herramientas, coste por caso y latencia máxima. Los límites deben partir del riesgo y del baseline del proceso, no de una cifra universal.
En CI/CD, cualquier cambio de instrucciones, modelo, herramienta o recuperación ejecuta la regresión. Si falla un criterio crítico, la versión no avanza. Para cambios importantes, compara la candidata con la versión vigente y revisa los casos donde gana cada una.
Evaluación continua después del despliegue
Producción aporta lenguaje, datos y combinaciones no previstas. Muestrea sesiones, filtra acciones sensibles y sigue tendencias. Una alerta útil enlaza la sesión y su trace, no se limita a indicar que bajó la media.
Los problemas revisados se convierten en nuevos casos de prueba. Versiona dataset, rúbrica, evaluador y agente para poder reproducir cada resultado.
Errores frecuentes
- probar solo casos felices;
- evaluar el texto final e ignorar herramientas;
- mezclar seguridad y estilo en una sola nota;
- confiar en un juez sin calibrarlo;
- cambiar dataset y umbral a la vez para aprobar;
- ocultar fallos raros de alto impacto detrás de la media;
- separar calidad de coste, latencia y resultado.
Plan de implantación
- Elige un agente y un objetivo: define el resultado de negocio.
- Mapea riesgos: políticas, herramientas, datos y efectos irreversibles.
- Crea un baseline: ejecuta casos reales anonimizados.
- Combina evaluadores: código, IA y calibración humana.
- Añade el control al pipeline: bloquea regresiones críticas.
- Supervisa producción: transforma fallos en pruebas.
- Revisa periódicamente: las rúbricas cambian con el proceso.
Calidad demostrable, no percibida
Una demo prueba que el agente funciona una vez. Una suite de evaluaciones muestra cómo se comporta ante cientos de situaciones, qué riesgos permanecen y cuándo una modificación deja de ser segura.
ProativaIA desarrolla agentes y automatizaciones empresariales, plataformas a medida e integraciones gobernadas. Podemos construir datasets, trazas, evaluadores y controles alineados con tu proceso y sus métricas de negocio.